GPU e IA · Inferencia en el borde

Servidor TPU en bare metal.Un Hailo-8 o un Coral Edge TPU, en una máquina Xeon que es solo tuya.

Un servidor TPU en Server Room es un cartucho HPE Moonshot con un módulo Hailo-8 o Google Coral Edge TPU en su ranura M.2, alquilado por meses con acceso root. Ejecuta modelos de visión int8 junto a tus datos: detección de objetos en flujos de cámara con Frigate, o tu propio código sobre el runtime del fabricante. No es una Cloud TPU de Google, que solo Google alquila, y no entrena ni sirve modelos de lenguaje grandes.

  • Un solo inquilino por máquina
  • Opción M.2 en m710x y m510
  • Root y consola remota
  • Red propia, AS19624

Elige el cartucho anfitrión, marca el módulo en el configurador y luego instala el runtime del fabricante en el sistema que hayas elegido. Hailo califica el Hailo-8 con hasta 26 TOPS y mantiene su cadena de herramientas al día. Google califica el Coral con 4 TOPS, y encaja en pipelines ya construidos para el Edge TPU.

Definición

Qué es un servidor TPU, y qué no es

TPU significa unidad de procesamiento tensorial, el nombre que Google dio a sus propios aceleradores matriciales. Dos piezas muy distintas llevan ese nombre. Las Cloud TPU son chips grandes para entrenar y servir modelos, y Google solo las alquila dentro de Google Cloud. El Edge TPU es el pequeño: unos dos vatios, solo enteros, construido para ejecutar un modelo de visión compilado junto a una cámara o un flujo de sensores.

Alquilamos el tipo pequeño y su rival más cercano, el Hailo-8, como módulo M.2 dentro de un servidor dedicado. Ambos son aceleradores de IA en el borde: ejecutan una red neuronal que ya ha sido entrenada y cuantizada a int8, y no hacen nada más.

Dimensionado para

Detección de objetos en fotogramas de vídeo, clasificación de imágenes, segmentación y estimación de pose. Redes de las familias MobileNet, EfficientDet-Lite y YOLO, cuantizadas a int8 y compiladas para el módulo, puntúan un fotograma sin que los datos salgan de tu máquina.

No dimensionado para

Entrenamiento de ningún tipo. Modelos de lenguaje, a cualquier cuantización: ninguno de los dos módulos puede contener miles de millones de parámetros. Modelos Float32 que no se cuantizan, y capas que el compilador del fabricante no soporta, que recaen en el procesador o no compilan.

A dónde van esos en su lugar

Dimensionar un modelo de lenguaje es trabajo del hosting de LLM. El entrenamiento y la inferencia grande se ejecutan en servidores dedicados con GPU, con una GPU dedicada por máquina. Una NPU y un gran conjunto de memoria en una caja son los servidores Ryzen AI.

Los dos módulos M.2

Hailo-8 o Coral Edge TPU

Ambos módulos aceptan una red int8 compilada de antemano por el compilador del propio fabricante. Se diferencian en el rendimiento nominal, en los frameworks que aceptan y, desde que Google archivó el software de Coral, en quién mantiene aún la pila.

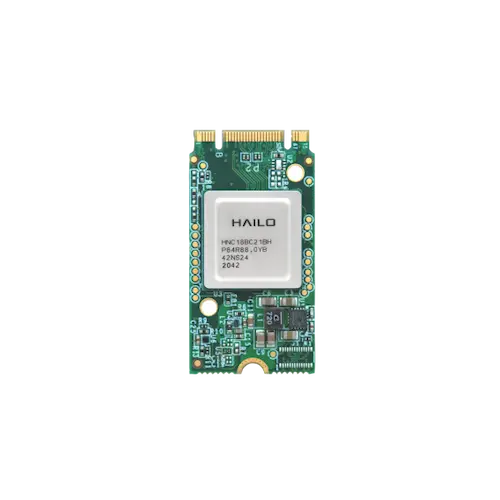
Módulo de aceleración de IA Hailo-8 M.2, vista superior
Cadena de herramientas mantenida

Módulo Hailo-8 M.2

Calificación (de Hailo)
hasta 26 TOPS, int8
Factor de forma
M.2 Key M, 22 × 42 mm, se extiende a 2280
Interfaz
PCIe Gen 3
Orígenes de modelos
TensorFlow, TensorFlow Lite, ONNX, Keras, PyTorch
Cadena de herramientas
Dataflow Compiler, HailoRT, Model Zoo
Runtime para Hailo-8
HailoRT 4.x, rama hailo8 (4.24.0, junio de 2026)
Precio de la opción
desde $13.99/mes

El Dataflow Compiler cuantiza tu red y la compila a un archivo HEF, y HailoRT ejecuta ese archivo desde C++ o Python. Usa la rama hailo8: HailoRT 5.x y la rama master solo soportan el Hailo-10 y el Hailo-15.
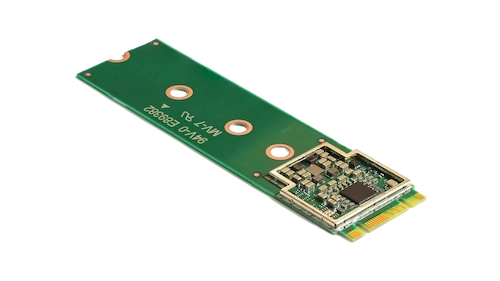
Acelerador Google Coral M.2 con Edge TPU
Archivado por Google

Acelerador Google Coral M.2

Calificación (de Google)
4 TOPS, int8, a 2 TOPS por vatio
Procesador
Google Edge TPU
Orígenes de modelos
TensorFlow Lite, int8, a través del Edge TPU Compiler
Runtime
libedgetpu y PyCoral, última versión de PyCoral 2.0.0 (julio de 2021)
Mantenimiento
Repositorios de Google archivados; los forks de la comunidad lo compilan hoy
Precio de la opción
desde $13.99/mes

Un modelo o bien compila para el Edge TPU o no lo hace, y los modelos de visión establecidos sí lo hacen. Google ha archivado libedgetpu, PyCoral y los repositorios del Edge TPU, así que los kernels actuales y las versiones de Python dependen de forks comunitarios del runtime y del controlador PCIe. Elígelo cuando tus modelos ya se ejecuten en un Edge TPU. Para un proyecto nuevo, empieza por el Hailo-8.

Las cifras de rendimiento son la calificación de cada fabricante. No publicamos ningún benchmark propio: los fotogramas por segundo dependen de tu modelo, de su tamaño de entrada y del lote.

Ruta de datos

Cómo funciona la descarga dentro de una máquina

El Xeon sigue decodificando el vídeo, redimensionando cada fotograma y ejecutando su aplicación. El módulo se encarga de la red neuronal y de nada más, de modo que los núcleos quedan libres para el trabajo que la rodea. En el m710x, los gráficos Iris Pro P580 del procesador pueden decodificar vídeo por hardware con Quick Sync, lo que deja sus cuatro núcleos para el resto.

Software

Qué se ejecuta en él, incluido Frigate

Frigate es el motivo habitual para poner uno de estos módulos en un servidor. Es un NVR de código abierto: extrae RTSP de sus cámaras, ejecuta un detector de objetos sobre una copia de baja resolución de cada flujo y graba los clips que el detector marca. Frigate 0.16 incluye un detector para cada módulo, de modo que los fotogramas se puntúan en la máquina que usted alquila.

Los dos detectores de Frigate

Hailo-8
detector hailo8l, dispositivo PCIe; el Hailo-8 y el 8L lo comparten
Coral
detector edgetpu, dispositivo pci para el módulo M.2
Modelos
YOLOv9, YOLOv6n y SSD MobileNet en el Hailo-8; en el Coral, YOLOv9 hay que convertirlo a mano
Tiempos de Frigate
unos 10 ms por fotograma para SSD MobileNet v1 y unos 18 ms para YOLOv9-tiny a 320 × 320, medidos en el Hailo-8L; alrededor de 10 ms para el Coral

El soporte de Hailo llegó al repositorio de Frigate en la 0.16. La propia página de hardware de Frigate ya no recomienda el Coral para una instalación nueva. Empiece un proyecto nuevo con el Hailo-8 y reserve el Coral para modelos ya compilados para el Edge TPU.

Dimensionar las cámaras

La detección no se ejecuta en cada fotograma. Frigate puntúa unos pocos fotogramas por segundo y cámara en el flujo de detección, y copia la grabación sin recodificarla. Un módulo que puntúa un fotograma en 10 ms sirve, por tanto, para del orden de un centenar de detecciones por segundo, repartidas entre sus cámaras.

El host suele agotarse antes que el módulo. El Xeon decodifica y redimensiona cada flujo, de modo que sus núcleos y su decodificador por hardware fijan el número de cámaras tanto como el módulo. Las grabaciones caen en los discos propios del cartucho, y los discos, la memoria y la velocidad del puerto son líneas del mismo configurador.

Sus cámaras aún tienen que llegar a la máquina. Frigate extrae RTSP por la red, y cada máquina se entrega con un puerto sin medición, de modo que los flujos entrantes no se facturan; el enlace desde el sitio donde están las cámaras, y el túnel por el que corre, son cosa suya.

Los tiempos de inferencia son cifras publicadas por Frigate para sus propios modelos, no una referencia nuestra. Instalamos el sistema operativo y le entregamos root: Frigate, el controlador PCIe y el runtime son suyos para instalar y fijar.

En vivo desde el catálogo de pedidos

Dos cartuchos host, con el precio que les da la caja

El módulo es una línea opcional en dos cartuchos HPE Moonshot: el m710x con un Xeon E3 de cuatro núcleos, y el m510 con un Xeon D de 8 o 16 núcleos. Cada precio de abajo es la configuración de entrada de esa línea, con el módulo como una línea más encima.

HPE ProLiant m710x

Intel Xeon E3-1585L v5

Intel Xeon E3-1585L v5 Quad Core 3.00 Ghz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Máquina, configuración de entrada
$62.58/mes
+ Google Coral Edge TPU
$13.99/mes
+ Hailo-8
$13.99/mes
Instalación, una vez
$29
Ciudades
New York, Bucharest, San Francisco, Amsterdam, Miami

Se factura en euros en Bucharest, Amsterdam, con las mismas cifras.

Configurar el m710x

HPE ProLiant m510

Intel Xeon D-1548 / Intel Xeon D-1587

Intel Xeon D-1548 Octa Core 2.00 GHz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Máquina, configuración de entrada
$62.58/mes
+ Google Coral Edge TPU
$13.99/mes
+ Hailo-8
$13.99/mes
Instalación, una vez
$29
Ciudades
New York, Miami, Bucharest, Amsterdam, San Francisco

Se factura en euros en Bucharest, Amsterdam, con las mismas cifras.

Configurar el m510

Un módulo cambia la máquina, de modo que el pedido es una configuración personalizada y lleva la tarifa de instalación única indicada. La memoria, los discos, la velocidad del puerto y el plazo de facturación se fijan en el mismo configurador, que muestra el total mensual final antes de pagar.

Puesta en marcha

Del pedido a la primera inferencia

Instalamos el sistema operativo y le entregamos root. El runtime del fabricante no viene preinstalado, de modo que la versión es suya para elegir y fijar.

  1. Configure el host. Abra el configurador del m710x o del m510, marque el Hailo-8 o el Coral, y elija el sistema operativo.
  2. Compruebe que el módulo está en el bus. Ejecute lspci -nn | grep -Ei '1e60|1ac1'. El Hailo-8 aparece como 1e60:2864 y el Coral como 1ac1:089a.
  3. Hailo-8: instale el controlador PCIe y HailoRT de la línea 4.x (la rama hailo8 de hailo-ai/hailort, o los paquetes de la Developer Zone de Hailo), y luego ejecute hailortcli fw-control identify para leer el firmware y el número de serie del módulo.
  4. Coral: compile el controlador PCIe gasket y apex y libedgetpu desde un fork mantenido, cargue el controlador y compruebe que /dev/apex_0 existe antes de ejecutar su primer modelo.
  5. Fije las versiones. Mantenga el kernel, el controlador y el runtime en versiones que funcionen juntas. Nada de nuestra parte actualiza la máquina a sus espaldas.

Respuestas

Preguntas sobre servidores TPU

¿Qué es un servidor TPU?

Un servidor con una unidad de procesamiento tensorial acoplada. En Server Room es un cartucho dedicado HPE Moonshot con un Google Coral Edge TPU o un Hailo-8 en su ranura M.2, para inferencia int8 en modelos de visión. Las Cloud TPU de Google son un chip distinto y mucho mayor, que solo se alquila dentro de Google Cloud.

¿Puedo alquilarles una Google Cloud TPU?

No. Las Cloud TPU solo están disponibles en Google Cloud, y ninguna empresa de alojamiento puede montar una en su rack. Para entrenar o servir modelos grandes en hardware que usted controla, vea nuestros servidores dedicados con GPU, donde cada máquina tiene una GPU dedicada.

¿Cuánto cuesta un servidor TPU?

Una máquina completa con un Hailo-8 o un Coral parte de $76.57 al mes. El módulo es una línea encima de la máquina, desde $13.99 al mes por el Hailo-8 y desde $13.99 por el Coral, y el pedido lleva una tarifa de instalación única desde $29. Las tarjetas de host de arriba muestran a qué máquina pertenece cada precio.

¿Hailo-8 o Coral Edge TPU: cuál elegir?

Hailo tasa el Hailo-8 en hasta 26 TOPS y Google tasa el Coral en 4 TOPS, ambos en int8. El Hailo-8 además tiene software mantenido: HailoRT 4.24.0 para él salió en junio de 2026, mientras que Google ha archivado los repositorios del Coral. Elija el Coral cuando sus modelos ya corran en un Edge TPU.

¿Puedo ejecutar Frigate NVR en un servidor TPU?

Sí. Frigate 0.16 tiene un detector para ambos módulos: el detector hailo8l con el dispositivo en PCIe para el Hailo-8, y el detector edgetpu con el dispositivo en pci para el Coral M.2. Frigate puntúa unos pocos fotogramas por segundo y cámara, de modo que un módulo sirve a varios flujos. Instalamos el sistema operativo y le entregamos root; Frigate, el controlador PCIe y el runtime son suyos para instalar y fijar.

¿Puede un servidor TPU ejecutar un LLM?

No. Ninguno de los dos módulos puede albergar un modelo con miles de millones de parámetros, a ninguna cuantización. Dimensiona el modelo en nuestra página de alojamiento de LLM y luego ejecútelo en un servidor dedicado con GPU o en una de nuestras máquinas Ryzen AI.

¿Qué sistemas operativos y controladores funcionan?

Se puede instalar cualquier sistema que el configurador ofrezca para el cartucho. HailoRT está compilado para Linux y Windows; el runtime del Coral y sus forks comunitarios apuntan a Linux. Nosotros instalamos el sistema, y usted instala el runtime en la versión que elija.

¿Dónde están ubicados sus servidores TPU?

Los servidores TPU se venden en estas ciudades: New York, Bucharest, San Francisco, Amsterdam, Miami. Corren en nuestra propia red, AS19624. Los pedidos en estas ciudades se facturan en euros, con las mismas cifras: Bucharest, Amsterdam.

¿La TPU se comparte con otros clientes?

No. El módulo está dentro de su cartucho y la máquina tiene un solo inquilino. Usted recibe root y la consola remota, y ninguna carga de trabajo de otro cliente corre en ella.

Elija un cartucho, marque el módulo

¿Preguntas antes de pedir? Nuestro chat con IA responde en segundos y puede revisar su cuenta y sus servidores, y una persona toma el relevo cuando usted lo pida.

Configurar un m710x