GPU i AI · Wnioskowanie brzegowe

Serwer TPU na gołym metalu.Coral Edge TPU lub Hailo-8 w maszynie Xeon, która należy wyłącznie do Ciebie.

Serwer TPU w Server Room to kartridż HPE Moonshot z modułem Google Coral Edge TPU lub Hailo-8 w slocie M.2, wynajmowany co miesiąc z dostępem root. Uruchamia modele wizyjne int8 obok Twoich danych. To nie jest Google Cloud TPU, który wynajmuje wyłącznie Google, i nie służy do trenowania ani obsługi dużych modeli językowych.

  • Jeden najemca na maszynę
  • Opcja M.2 w m710x i m510
  • Root i zdalna konsola
  • Własna sieć, AS19624

Wybierz kartridż hosta, zaznacz moduł w konfiguratorze, a następnie zainstaluj środowisko uruchomieniowe producenta na wybranym systemie. Hailo ocenia Hailo-8 na maksymalnie 26 TOPS i stale aktualizuje swój łańcuch narzędzi. Google ocenia Coral na 4 TOPS, co pasuje do potoków już zbudowanych dla Edge TPU.

Definicja

Czym jest serwer TPU, a czym nie jest

TPU to skrót od tensor processing unit, nazwy, którą Google nadał swoim akceleratorom macierzowym. Noszą ją dwa bardzo różne układy. Cloud TPU to duże chipy do trenowania i obsługi modeli, które Google wynajmuje wyłącznie w Google Cloud. Edge TPU to ten mały: około dwóch watów, wyłącznie liczby całkowite, zbudowany do uruchamiania skompilowanego modelu wizyjnego obok kamery lub strumienia z czujnika.

Wynajmujemy ten mały rodzaj i jego najbliższego rywala, Hailo-8, jako moduł M.2 wewnątrz serwera dedykowanego. Oba to brzegowe akceleratory AI: uruchamiają sieć neuronową, która została już wytrenowana i skwantyzowana do int8, i nie robią nic więcej.

Przeznaczony do

Wykrywania obiektów na klatkach wideo, klasyfikacji obrazów, segmentacji i estymacji pozy. Sieci z rodzin MobileNet, EfficientDet-Lite i YOLO, skwantyzowane do int8 i skompilowane dla modułu, oceniają klatkę bez opuszczania Twojej maszyny przez dane.

Nieprzeznaczony do

Trenowania jakiegokolwiek rodzaju. Modeli językowych, przy dowolnej kwantyzacji: żaden moduł nie pomieści miliardów parametrów. Modeli Float32, które się nie kwantyzują, oraz warstw, których kompilator producenta nie obsługuje, a które spadają na procesor lub nie kompilują się wcale.

Gdzie one trafiają zamiast tego

Dobór rozmiaru modelu językowego to zadanie hostingu LLM. Trenowanie i duże wnioskowanie działają na dedykowanych serwerach GPU, z dedykowanym GPU na maszynę. NPU i duża pula pamięci w jednej obudowie to serwery Ryzen AI.

Dwa moduły M.2

Hailo-8 lub Coral Edge TPU

Oba moduły przyjmują sieć int8 skompilowaną wcześniej przez kompilator producenta. Różnią się deklarowaną przepustowością, obsługiwanymi frameworkami oraz — odkąd Google zarchiwizował oprogramowanie Coral — tym, kto nadal utrzymuje stos.

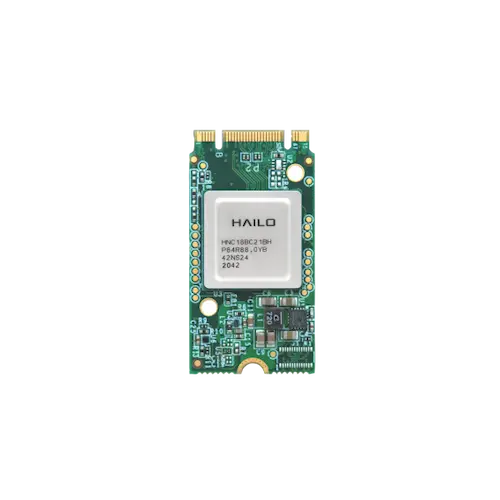
Moduł akceleracji AI Hailo-8 M.2, widok z góry
Utrzymywany łańcuch narzędzi

Moduł Hailo-8 M.2

Ocena (wg Hailo)
do 26 TOPS, int8
Format
M.2 Key M, 22 × 42 mm, rozszerzalny do 2280
Interfejs
PCIe Gen 3
Źródła modeli
TensorFlow, TensorFlow Lite, ONNX, Keras, PyTorch
Łańcuch narzędzi
Dataflow Compiler, HailoRT, Model Zoo
Środowisko dla Hailo-8
HailoRT 4.x, gałąź hailo8 (4.24.0, czerwiec 2026)
Cena opcji
od $13.99/mies.

Dataflow Compiler kwantyzuje Twoją sieć i kompiluje ją do pliku HEF, a HailoRT uruchamia ten plik z C++ lub Pythona. Użyj gałęzi hailo8: HailoRT 5.x i gałąź master obsługują tylko Hailo-10 i Hailo-15.
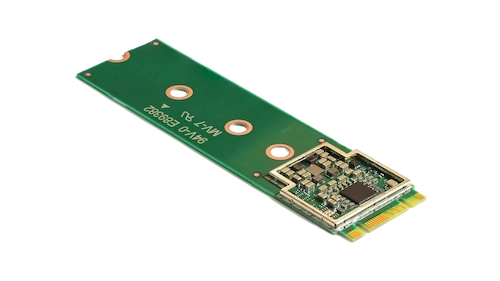
Akcelerator Google Coral M.2 z Edge TPU
Zarchiwizowany przez Google

Akcelerator Google Coral M.2

Ocena (wg Google)
4 TOPS, int8, przy 2 TOPS na wat
Procesor
Google Edge TPU
Źródła modeli
TensorFlow Lite, int8, przez Edge TPU Compiler
Środowisko
libedgetpu i PyCoral, ostatnie wydanie PyCoral 2.0.0 (lipiec 2021)
Utrzymanie
Repozytoria Google zarchiwizowane; dziś budują je forki społeczności
Cena opcji
od $13.99/mies.

Model albo kompiluje się dla Edge TPU, albo nie, a uznane modele wizyjne się kompilują. Google zarchiwizował libedgetpu, PyCoral i repozytoria Edge TPU, więc obecne jądra i wersje Pythona polegają na forkach społecznościowych środowiska i sterownika PCIe. Wybierz go, gdy Twoje modele już działają na Edge TPU. Do nowego projektu zacznij od Hailo-8.

Wartości przepustowości to oceny każdego z producentów. Nie publikujemy własnych benchmarków: liczba klatek na sekundę zależy od Twojego modelu, rozmiaru wejścia i partii.

Ścieżka danych

Jak działa odciążanie w obrębie jednej maszyny

Xeon nadal dekoduje wideo, skaluje każdą klatkę i uruchamia Twoją aplikację. Moduł przejmuje sieć neuronową i nic poza tym, więc rdzenie pozostają wolne dla pracy wokół niej. W modelu m710x zintegrowana grafika Iris Pro P580 procesora potrafi dekodować wideo sprzętowo dzięki Quick Sync, co zostawia cztery rdzenie dla reszty zadań.

Na żywo z katalogu zamówień

Dwa kartridże hosta, wycenione tak, jak wycenia je koszyk

Moduł jest pozycją opcjonalną w dwóch kartridżach HPE Moonshot: m710x z czterordzeniowym Xeonem E3 oraz m510 z 8- lub 16-rdzeniowym Xeonem D. Każda cena poniżej to podstawowa konfiguracja danej linii, z modułem jako jedną pozycją dodatkową.

HPE ProLiant m710x

Intel Xeon E3-1585L v5

Intel Xeon E3-1585L v5 Quad Core 3.00 Ghz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Maszyna, konfiguracja podstawowa
$62.58/mies.
+ Google Coral Edge TPU
$13.99/mies.
+ Hailo-8
$13.99/mies.
Opłata instalacyjna, jednorazowo
$29
Lokalizacje
New York, Bucharest, San Francisco, Amsterdam, Miami

Fakturowane w euro w Bucharest, Amsterdam, w tych samych kwotach.

Skonfiguruj m710x

HPE ProLiant m510

Intel Xeon D-1548 / Intel Xeon D-1587

Intel Xeon D-1548 Octa Core 2.00 GHz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Maszyna, konfiguracja podstawowa
$62.58/mies.
+ Google Coral Edge TPU
$13.99/mies.
+ Hailo-8
$13.99/mies.
Opłata instalacyjna, jednorazowo
$29
Lokalizacje
New York, Miami, Bucharest, Amsterdam, San Francisco

Fakturowane w euro w Bucharest, Amsterdam, w tych samych kwotach.

Skonfiguruj m510

Moduł zmienia maszynę, więc zamówienie jest konfiguracją niestandardową i wiąże się z pokazaną jednorazową opłatą instalacyjną. Pamięć, dyski, prędkość portów i okres rozliczeniowy ustawia się w tym samym konfiguratorze, który przed płatnością pokazuje ostateczną sumę miesięczną.

Konfiguracja

Od zamówienia do pierwszej inferencji

Instalujemy system operacyjny i przekazujemy Ci uprawnienia roota. Środowisko uruchomieniowe producenta nie jest preinstalowane, więc jego wersję wybierasz i przypinasz samodzielnie.

  1. Skonfiguruj hosta. Otwórz konfigurator m710x lub m510, zaznacz Hailo-8 albo Coral i wybierz system operacyjny.
  2. Sprawdź, czy moduł jest widoczny na magistrali. Uruchom lspci -nn | grep -Ei '1e60|1ac1'. Hailo-8 widnieje jako 1e60:2864, a Coral jako 1ac1:089a.
  3. Hailo-8: zainstaluj sterownik PCIe i HailoRT z linii 4.x (gałąź hailo8 repozytorium hailo-ai/hailort lub pakiety ze strefy deweloperskiej Hailo), a następnie uruchom hailortcli fw-control identify, aby odczytać firmware i numer seryjny modułu.
  4. Coral: zbuduj sterownik PCIe gasket i apex oraz libedgetpu z utrzymywanego forka, załaduj sterownik i sprawdź, czy /dev/apex_0 istnieje, zanim uruchomisz pierwszy model.
  5. Przypnij wersje. Utrzymuj jądro, sterownik i środowisko uruchomieniowe w wersjach, które ze sobą współpracują. Po naszej stronie nic nie aktualizuje maszyny za Twoimi plecami.

Odpowiedzi

Pytania o serwery TPU

Czym jest serwer TPU?

Serwer z podłączoną jednostką przetwarzania tensorowego. W Server Room to dedykowany kartridż HPE Moonshot z Google Coral Edge TPU lub Hailo-8 w slocie M.2, przeznaczony do inferencji int8 na modelach wizyjnych. Cloud TPU Google to inny, znacznie większy układ, wynajmowany wyłącznie w Google Cloud.

Czy mogę wynająć od Was Google Cloud TPU?

Nie. Cloud TPU są dostępne tylko w Google Cloud i żadna firma hostingowa nie może ich postawić we własnej szafie. Do trenowania lub serwowania dużych modeli na sprzęcie, który kontrolujesz, zobacz nasze serwery dedykowane z GPU, gdzie każda maszyna ma dedykowany procesor graficzny.

Ile kosztuje serwer TPU?

Kompletna maszyna z Hailo-8 lub Coralem zaczyna się od $76.57 miesięcznie. Moduł to jedna pozycja doliczana do maszyny: od $13.99 miesięcznie za Hailo-8 i od $13.99 za Coral, a zamówienie wiąże się z jednorazową opłatą instalacyjną od $29. Powyższe karty hostów pokazują, do której maszyny należy dana cena.

Hailo-8 czy Coral Edge TPU: co wybrać?

Hailo ocenia Hailo-8 na maksymalnie 26 TOPS, a Google ocenia Coral na 4 TOPS, oba w int8. Hailo-8 ma też utrzymywane oprogramowanie: HailoRT 4.24.0 dla niego ukazał się w czerwcu 2026 roku, podczas gdy Google zarchiwizowało repozytoria Coral. Wybierz Coral, gdy Twoje modele już działają na Edge TPU.

Czy serwer TPU uruchomi LLM?

Nie. Żaden z tych modułów nie pomieści modelu o miliardach parametrów, przy jakiejkolwiek kwantyzacji. Dobierz model na naszej stronie hostingu LLM, a następnie uruchom go na serwerze dedykowanym z GPU lub na jednej z naszych maszyn Ryzen AI.

Jakie systemy operacyjne i sterowniki działają?

Można zainstalować każdy system, który konfigurator oferuje dla danego kartridża. HailoRT jest przeznaczony dla Linuksa i Windows; środowisko Coral i jego forki społecznościowe celują w Linuksa. My instalujemy system, a Ty instalujesz środowisko uruchomieniowe w wybranej przez siebie wersji.

Gdzie znajdują się Wasze serwery TPU?

Serwery TPU są sprzedawane w tych lokalizacjach: New York, Bucharest, San Francisco, Amsterdam, Miami. Działają w naszej własnej sieci, AS19624. Zamówienia w tych lokalizacjach są fakturowane w euro, w tych samych kwotach: Bucharest, Amsterdam.

Czy TPU jest współdzielone z innymi klientami?

Nie. Moduł znajduje się wewnątrz Twojego kartridża, a maszyna ma jednego najemcę. Otrzymujesz roota i zdalną konsolę, a obciążenia innych klientów nie są na niej uruchamiane.

Wybierz kartridż, zaznacz moduł

Masz pytania przed złożeniem zamówienia? Nasz czat AI odpowiada w kilka sekund i może sprawdzić Twoje konto oraz serwery, a człowiek przejmuje rozmowę, kiedy tylko poprosisz.

Skonfiguruj m710x