GPU und KI · Edge-Inferenz

TPU-Server auf Bare Metal.Eine Coral Edge TPU oder eine Hailo-8, in einer Xeon-Maschine, die Ihnen allein gehört.

Ein TPU-Server bei Server Room ist ein HPE-Moonshot-Cartridge mit einer Google Coral Edge TPU oder einem Hailo-8-Modul im M.2-Steckplatz, monatlich gemietet mit Root-Zugriff. Er führt int8-Vision-Modelle direkt neben Ihren Daten aus. Es ist keine Google Cloud TPU, die nur Google vermietet, und er trainiert oder bedient keine großen Sprachmodelle.

  • Ein Mandant pro Maschine
  • M.2-Option bei m710x und m510
  • Root und Remote-Konsole
  • Eigenes Netz, AS19624

Wählen Sie das Host-Cartridge, setzen Sie das Modul im Konfigurator, und installieren Sie dann die Hersteller-Laufzeitumgebung auf dem gewählten System. Hailo bewertet die Hailo-8 mit bis zu 26 TOPS und hält seine Toolchain aktuell. Google bewertet die Coral mit 4 TOPS, und sie passt zu Pipelines, die bereits für die Edge TPU gebaut wurden.

Definition

Was ein TPU-Server ist – und was nicht

TPU steht für Tensor Processing Unit, der Name, den Google seinen eigenen Matrix-Beschleunigern gegeben hat. Zwei sehr unterschiedliche Bauteile tragen diesen Namen. Cloud-TPUs sind große Chips zum Trainieren und Bedienen von Modellen, und Google vermietet sie ausschließlich innerhalb von Google Cloud. Die Edge TPU ist die kleine Variante: etwa zwei Watt, nur Ganzzahlen, gebaut, um ein kompiliertes Vision-Modell direkt neben einer Kamera oder einem Sensor-Feed auszuführen.

Wir vermieten die kleine Variante und ihren engsten Konkurrenten, die Hailo-8, als M.2-Modul in einem dedizierten Server. Beide sind Edge-KI-Beschleuniger: Sie führen ein neuronales Netz aus, das bereits trainiert und auf int8 quantisiert wurde, und sonst nichts.

Ausgelegt für

Objekterkennung auf Videoframes, Bildklassifikation, Segmentierung und Posenschätzung. Netze aus den Familien MobileNet, EfficientDet-Lite und YOLO, quantisiert auf int8 und für das Modul kompiliert, bewerten ein Frame, ohne dass die Daten Ihre Maschine verlassen.

Nicht ausgelegt für

Training jeglicher Art. Sprachmodelle, bei jeder Quantisierung: Keines der Module kann Milliarden von Parametern halten. Float32-Modelle, die sich nicht quantisieren lassen, und Schichten, die der Hersteller-Compiler nicht unterstützt, fallen auf den Prozessor zurück oder schlagen beim Kompilieren fehl.

Wohin diese stattdessen gehören

Die Dimensionierung eines Sprachmodells ist Aufgabe des LLM-Hostings. Training und große Inferenz laufen auf dedizierten GPU-Servern, mit einer dedizierten GPU pro Maschine. Eine NPU und ein großer Speicherpool in einer Box sind Ryzen-AI-Server.

Die beiden M.2-Module

Hailo-8 oder Coral Edge TPU

Beide Module nehmen ein int8-Netz entgegen, das im Voraus vom Compiler des jeweiligen Herstellers kompiliert wurde. Sie unterscheiden sich im angegebenen Durchsatz, in den unterstützten Frameworks und – seit Google die Coral-Software archiviert hat – darin, wer den Stack noch pflegt.

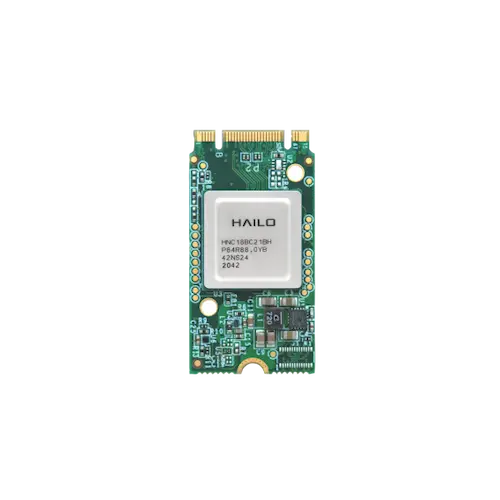
Hailo-8 M.2 KI-Beschleunigungsmodul, Draufsicht
Gepflegte Toolchain

Hailo-8 M.2-Modul

Leistung (laut Hailo)
bis zu 26 TOPS, int8
Formfaktor
M.2 Key M, 22 × 42 mm, erweiterbar auf 2280
Schnittstelle
PCIe Gen 3
Modellquellen
TensorFlow, TensorFlow Lite, ONNX, Keras, PyTorch
Toolchain
Dataflow Compiler, HailoRT, Model Zoo
Laufzeit für Hailo-8
HailoRT 4.x, hailo8-Branch (4.24.0, Juni 2026)
Optionspreis
ab $13.99/Monat

Der Dataflow Compiler quantisiert Ihr Netz und kompiliert es in eine HEF-Datei, und HailoRT führt diese Datei aus C++ oder Python aus. Verwenden Sie den hailo8-Branch: HailoRT 5.x und der Master-Branch unterstützen nur die Hailo-10 und Hailo-15.
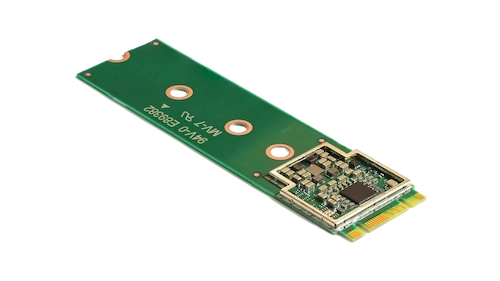
Google Coral M.2 Accelerator mit Edge TPU
Von Google archiviert

Google Coral M.2 Accelerator

Leistung (laut Google)
4 TOPS, int8, bei 2 TOPS pro Watt
Prozessor
Google Edge TPU
Modellquellen
TensorFlow Lite, int8, über den Edge TPU Compiler
Laufzeit
libedgetpu und PyCoral, letzte PyCoral-Version 2.0.0 (Juli 2021)
Wartung
Google-Repositories archiviert; Community-Forks bauen sie heute
Optionspreis
ab $13.99/Monat

Ein Modell kompiliert entweder für die Edge TPU oder nicht, und die etablierten Vision-Modelle tun es. Google hat libedgetpu, PyCoral und die Edge-TPU-Repositories archiviert, daher sind aktuelle Kernel und Python-Versionen auf Community-Forks der Laufzeit und des PCIe-Treibers angewiesen. Wählen Sie sie, wenn Ihre Modelle bereits auf einer Edge TPU laufen. Für ein neues Projekt starten Sie mit der Hailo-8.

Die Durchsatzangaben sind die jeweiligen Herstellerangaben. Wir veröffentlichen keine eigenen Benchmarks: Frames pro Sekunde hängen von Ihrem Modell, seiner Eingabegröße und dem Batch ab.

Datenpfad

So funktioniert das Offloading in einer einzigen Maschine

Der Xeon dekodiert weiterhin das Video, skaliert jedes Bild und führt Ihre Anwendung aus. Das Modul übernimmt ausschließlich das neuronale Netz, sodass die Kerne für die umliegenden Aufgaben frei bleiben. Auf dem m710x kann die integrierte Iris-Pro-P580-Grafik des Prozessors Video per Quick Sync hardwarebeschleunigt dekodieren, wodurch seine vier Kerne für den Rest verfügbar bleiben.

Live aus dem Bestellkatalog

Zwei Host-Cartridges, bepreist wie an der Kasse

Das Modul ist eine Optionszeile auf zwei HPE-Moonshot-Cartridges: dem m710x mit einem Quad-Core-Xeon E3 und dem m510 mit einem Xeon D mit 8 oder 16 Kernen. Jeder Preis unten ist die Einstiegskonfiguration dieser Linie, mit dem Modul als einer Zeile obendrauf.

HPE ProLiant m710x

Intel Xeon E3-1585L v5

Intel Xeon E3-1585L v5 Quad Core 3.00 Ghz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Maschine, Einstiegskonfiguration
$62.58/Monat
+ Google Coral Edge TPU
$13.99/Monat
+ Hailo-8
$13.99/Monat
Einrichtung, einmalig
$29
Städte
New York, Bucharest, San Francisco, Amsterdam, Miami

Abrechnung in Euro in Bucharest, Amsterdam, zu denselben Beträgen.

m710x konfigurieren

HPE ProLiant m510

Intel Xeon D-1548 / Intel Xeon D-1587

Intel Xeon D-1548 Octa Core 2.00 GHz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Maschine, Einstiegskonfiguration
$62.58/Monat
+ Google Coral Edge TPU
$13.99/Monat
+ Hailo-8
$13.99/Monat
Einrichtung, einmalig
$29
Städte
New York, Miami, Bucharest, Amsterdam, San Francisco

Abrechnung in Euro in Bucharest, Amsterdam, zu denselben Beträgen.

m510 konfigurieren

Ein Modul verändert die Maschine, daher ist die Bestellung eine Sonderanfertigung und trägt die angezeigte einmalige Einrichtungsgebühr. Arbeitsspeicher, Festplatten, Portgeschwindigkeit und Abrechnungszeitraum werden alle im selben Konfigurator festgelegt, der die endgültige Monatssumme anzeigt, bevor Sie zahlen.

Einrichtung

Von der Bestellung bis zur ersten Inferenz

Wir installieren das Betriebssystem und übergeben Ihnen Root. Die Laufzeitumgebung des Anbieters ist nicht vorinstalliert, daher liegt die Wahl und Festlegung der Version bei Ihnen.

  1. Host konfigurieren. Öffnen Sie den m710x- oder m510-Konfigurator, wählen Sie den Hailo-8 oder den Coral und das Betriebssystem.
  2. Prüfen, ob das Modul am Bus ist. Führen Sie lspci -nn | grep -Ei '1e60|1ac1' aus. Der Hailo-8 erscheint als 1e60:2864 und der Coral als 1ac1:089a.
  3. Hailo-8: Installieren Sie den PCIe-Treiber und HailoRT aus der 4.x-Linie (der hailo8-Zweig von hailo-ai/hailort oder die Pakete aus Hailos Developer Zone) und führen Sie dann hailortcli fw-control identify aus, um Firmware und Seriennummer des Moduls auszulesen.
  4. Coral: Bauen Sie den Gasket- und Apex-PCIe-Treiber sowie libedgetpu aus einem gepflegten Fork, laden Sie den Treiber und prüfen Sie, ob /dev/apex_0 existiert, bevor Sie Ihr erstes Modell ausführen.
  5. Versionen festlegen. Halten Sie Kernel, Treiber und Laufzeitumgebung auf Versionen, die zusammen funktionieren. Auf unserer Seite aktualisiert nichts die Maschine hinter Ihrem Rücken.

Antworten

Fragen zu TPU-Servern

Was ist ein TPU-Server?

Ein Server mit einer angeschlossenen Tensor Processing Unit. Bei Server Room ist das eine dedizierte HPE-Moonshot-Cartridge mit einem Google Coral Edge TPU oder einem Hailo-8 im M.2-Steckplatz, für int8-Inferenz auf Vision-Modellen. Googles Cloud-TPUs sind ein anderer und deutlich größerer Chip, der nur innerhalb der Google Cloud gemietet werden kann.

Kann ich bei Ihnen eine Google Cloud TPU mieten?

Nein. Cloud-TPUs gibt es nur in der Google Cloud, und kein Hosting-Anbieter kann eine einbauen. Für Training oder das Bereitstellen großer Modelle auf Hardware, die Sie kontrollieren, sehen Sie sich unsere GPU-Dedicated-Server an, bei denen jede Maschine eine dedizierte GPU hat.

Wie viel kostet ein TPU-Server?

Eine komplette Maschine mit einem Hailo-8 oder einem Coral beginnt bei $76.57 pro Monat. Das Modul ist eine Zeile obendrauf, ab $13.99 pro Monat für den Hailo-8 und ab $13.99 für den Coral, und die Bestellung trägt eine einmalige Einrichtungsgebühr ab $29. Die Host-Karten oben zeigen, zu welcher Maschine jeder Preis gehört.

Hailo-8 oder Coral Edge TPU: Was soll ich wählen?

Hailo bewertet den Hailo-8 mit bis zu 26 TOPS und Google den Coral mit 4 TOPS, beide bei int8. Der Hailo-8 hat außerdem gepflegte Software: HailoRT 4.24.0 dafür erschien im Juni 2026, während Google die Coral-Repositories archiviert hat. Wählen Sie den Coral, wenn Ihre Modelle bereits auf einem Edge TPU laufen.

Kann ein TPU-Server ein LLM ausführen?

Nein. Keines der beiden Module kann ein Modell mit Milliarden von Parametern halten, bei keiner Quantisierung. Dimensionieren Sie das Modell auf unserer LLM-Hosting-Seite und führen Sie es dann auf einem GPU-Dedicated-Server oder einer unserer Ryzen-AI-Maschinen aus.

Welche Betriebssysteme und Treiber funktionieren?

Jedes System, das der Konfigurator für die Cartridge anbietet, kann installiert werden. HailoRT ist für Linux und Windows gebaut; die Coral-Laufzeitumgebung und ihre Community-Forks zielen auf Linux. Wir installieren das System, und Sie installieren die Laufzeitumgebung in der von Ihnen gewählten Version.

Wo stehen Ihre TPU-Server?

TPU-Server werden in diesen Städten verkauft: New York, Bucharest, San Francisco, Amsterdam, Miami. Sie laufen in unserem eigenen Netz, AS19624. Bestellungen in diesen Städten werden in Euro abgerechnet, zu denselben Beträgen: Bucharest, Amsterdam.

Wird die TPU mit anderen Kunden geteilt?

Nein. Das Modul sitzt in Ihrer Cartridge und die Maschine hat einen einzigen Mieter. Sie erhalten Root und die Remote-Konsole, und keine Arbeitslast eines anderen Kunden läuft darauf.

Wählen Sie eine Cartridge, aktivieren Sie das Modul

Fragen vor der Bestellung? Unser Chat-KI antwortet in Sekunden und kann Ihr Konto und Ihre Server prüfen, und ein Mensch übernimmt, wann immer Sie es wünschen.

m710x konfigurieren