GPU e AI · Inferenza edge

Server TPU su bare metal.Un Coral Edge TPU o un Hailo-8, in una macchina Xeon tutta tua.

Un server TPU su Server Room è una cartuccia HPE Moonshot con un Google Coral Edge TPU o un modulo Hailo-8 nello slot M.2, noleggiata mensilmente con accesso root. Esegue modelli di visione int8 accanto ai tuoi dati. Non è una Cloud TPU di Google, che affitta solo Google, e non addestra né serve modelli linguistici di grandi dimensioni.

  • Un solo tenant per macchina
  • Opzione M.2 su m710x e m510
  • Root e console remota
  • Rete propria, AS19624

Scegli la cartuccia host, spunta il modulo nel configuratore, poi installa il runtime del produttore sul sistema che hai scelto. Hailo valuta l'Hailo-8 fino a 26 TOPS e mantiene aggiornata la sua toolchain. Google valuta il Coral a 4 TOPS, ed è adatto a pipeline già costruite per l'Edge TPU.

Definizione

Cos'è un server TPU, e cosa non è

TPU sta per tensor processing unit, il nome che Google ha dato ai propri acceleratori matriciali. Due componenti molto diversi portano questo nome. Le Cloud TPU sono chip di grandi dimensioni per l'addestramento e l'esecuzione di modelli, e Google li affitta solo all'interno di Google Cloud. L'Edge TPU è quello piccolo: circa due watt, solo numeri interi, costruito per eseguire un modello di visione compilato accanto a una telecamera o a un flusso di sensori.

Noi noleggiamo il tipo piccolo e il suo rivale più diretto, l'Hailo-8, come modulo M.2 all'interno di un server dedicato. Entrambi sono acceleratori AI edge: eseguono una rete neurale già addestrata e quantizzata in int8, e non fanno altro.

Adatto per

Rilevamento di oggetti su fotogrammi video, classificazione di immagini, segmentazione e stima della posa. Le reti delle famiglie MobileNet, EfficientDet-Lite e YOLO, quantizzate in int8 e compilate per il modulo, elaborano un fotogramma senza che i dati lascino la tua macchina.

Non adatto per

Addestramento di qualsiasi tipo. Modelli linguistici, a qualsiasi quantizzazione: nessuno dei due moduli può contenere miliardi di parametri. Modelli Float32 che non si quantizzano, e livelli che il compilatore del produttore non supporta, che ricadono sul processore o non riescono a compilare.

Dove vanno invece quelli

Dimensionare un modello linguistico è il compito dell'hosting LLM. L'addestramento e l'inferenza su larga scala girano su server dedicati GPU, con una GPU dedicata per macchina. Una NPU e un ampio pool di memoria in un unico box sono i server Ryzen AI.

I due moduli M.2

Hailo-8 o Coral Edge TPU

Entrambi i moduli accettano una rete int8 compilata in anticipo dal compilatore del produttore. Differiscono per throughput nominale, per i framework che accettano e, dato che Google ha archiviato il software Coral, per chi mantiene ancora lo stack.

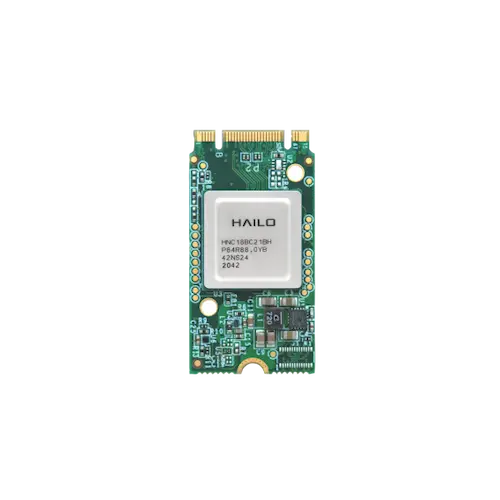
Modulo di accelerazione AI Hailo-8 M.2, vista dall'alto
Toolchain mantenuta

Modulo Hailo-8 M.2

Valutazione (di Hailo)
fino a 26 TOPS, int8
Fattore di forma
M.2 Key M, 22 × 42 mm, estensibile a 2280
Interfaccia
PCIe Gen 3
Origini dei modelli
TensorFlow, TensorFlow Lite, ONNX, Keras, PyTorch
Toolchain
Dataflow Compiler, HailoRT, Model Zoo
Runtime per Hailo-8
HailoRT 4.x, ramo hailo8 (4.24.0, giugno 2026)
Prezzo dell'opzione
da $13.99/mese

Il Dataflow Compiler quantizza la tua rete e la compila in un file HEF, e HailoRT esegue quel file da C++ o Python. Usa il ramo hailo8: HailoRT 5.x e il ramo master supportano solo Hailo-10 e Hailo-15.
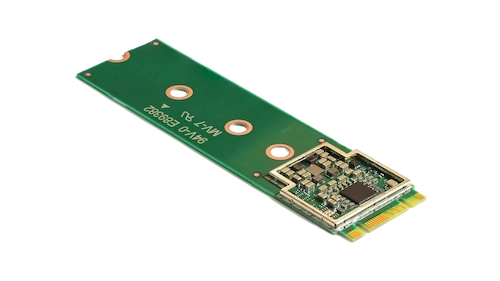
Acceleratore Google Coral M.2 con Edge TPU
Archiviato da Google

Acceleratore Google Coral M.2

Valutazione (di Google)
4 TOPS, int8, a 2 TOPS per watt
Processore
Google Edge TPU
Origini dei modelli
TensorFlow Lite, int8, tramite Edge TPU Compiler
Runtime
libedgetpu e PyCoral, ultima release PyCoral 2.0.0 (luglio 2021)
Manutenzione
Repository Google archiviati; oggi lo compilano i fork della community
Prezzo dell'opzione
da $13.99/mese

Un modello o compila per l'Edge TPU o non compila, e i modelli di visione consolidati compilano. Google ha archiviato libedgetpu, PyCoral e i repository dell'Edge TPU, quindi i kernel attuali e le versioni di Python si affidano ai fork della community del runtime e del driver PCIe. Sceglilo quando i tuoi modelli girano già su un Edge TPU. Per un nuovo progetto, parti con l'Hailo-8.

I dati di throughput sono la valutazione di ciascun produttore. Non pubblichiamo benchmark nostri: i fotogrammi al secondo dipendono dal tuo modello, dalla dimensione dell'input e dal batch.

Percorso dei dati

Come funziona l'offload all'interno di una macchina

Lo Xeon decodifica ancora il video, ridimensiona ogni fotogramma ed esegue la tua applicazione. Il modulo si occupa della rete neurale e di nient'altro, così i core restano liberi per il lavoro circostante. Sull'm710x, la grafica Iris Pro P580 del processore può decodificare il video in hardware con Quick Sync, lasciando i suoi quattro core per il resto.

In tempo reale dal catalogo ordini

Due cartucce host, prezzate come le prezza il checkout

Il modulo è una voce opzionale su due cartucce HPE Moonshot: l'm710x con uno Xeon E3 quad-core, e l'm510 con uno Xeon D a 8 o 16 core. Ogni prezzo qui sotto è la configurazione base di quella linea, con il modulo come voce aggiuntiva.

HPE ProLiant m710x

Intel Xeon E3-1585L v5

Intel Xeon E3-1585L v5 Quad Core 3.00 Ghz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Macchina, configurazione base
$62.58/mese
+ Google Coral Edge TPU
$13.99/mese
+ Hailo-8
$13.99/mese
Setup, una tantum
$29
Città
New York, Bucharest, San Francisco, Amsterdam, Miami

Fatturato in euro in Bucharest, Amsterdam, con le stesse cifre.

Configura l'm710x

HPE ProLiant m510

Intel Xeon D-1548 / Intel Xeon D-1587

Intel Xeon D-1548 Octa Core 2.00 GHz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Macchina, configurazione base
$62.58/mese
+ Google Coral Edge TPU
$13.99/mese
+ Hailo-8
$13.99/mese
Setup, una tantum
$29
Città
New York, Miami, Bucharest, Amsterdam, San Francisco

Fatturato in euro in Bucharest, Amsterdam, con le stesse cifre.

Configura l'm510

Un modulo cambia la macchina, quindi l'ordine è una configurazione personalizzata e comporta la tariffa di setup una tantum indicata. Memoria, dischi, velocità della porta e durata del contratto si impostano tutti nello stesso configuratore, che mostra il totale mensile finale prima del pagamento.

Configurazione

Dall'ordine alla prima inferenza

Installiamo il sistema operativo e ti consegniamo l'accesso root. Il runtime del fornitore non è preinstallato, quindi la versione è tua da scegliere e bloccare.

  1. Configura l'host. Apri il configuratore m710x o m510, seleziona l'Hailo-8 o il Coral e scegli il sistema operativo.
  2. Verifica che il modulo sia sul bus. Esegui lspci -nn | grep -Ei '1e60|1ac1'. L'Hailo-8 appare come 1e60:2864 e il Coral come 1ac1:089a.
  3. Hailo-8: installa il driver PCIe e HailoRT dalla linea 4.x (il ramo hailo8 di hailo-ai/hailort, o i pacchetti della Developer Zone di Hailo), poi esegui hailortcli fw-control identify per leggere firmware e numero di serie del modulo.
  4. Coral: compila il driver PCIe gasket e apex e libedgetpu da un fork mantenuto, carica il driver e verifica che /dev/apex_0 esista prima di eseguire il tuo primo modello.
  5. Blocca le versioni. Mantieni kernel, driver e runtime su versioni compatibili tra loro. Nulla da parte nostra aggiorna la macchina a tua insaputa.

Risposte

Domande sui server TPU

Cos'è un server TPU?

Un server con un'unità di elaborazione tensoriale collegata. Da Server Room è una cartuccia dedicata HPE Moonshot con un Google Coral Edge TPU o un Hailo-8 nello slot M.2, per inferenza int8 su modelli di visione. Le Cloud TPU di Google sono un chip diverso e molto più grande, noleggiabile solo all'interno di Google Cloud.

Posso noleggiare una Google Cloud TPU da voi?

No. Le Cloud TPU sono disponibili solo in Google Cloud e nessuna azienda di hosting può montarne una. Per addestrare o servire modelli di grandi dimensioni su hardware che controlli, vedi i nostri server dedicati con GPU, dove ogni macchina ha una GPU dedicata.

Quanto costa un server TPU?

Una macchina completa con un Hailo-8 o un Coral parte da $76.57 al mese. Il modulo è una voce aggiuntiva sulla macchina, da $13.99 al mese per l'Hailo-8 e da $13.99 per il Coral, e l'ordine comporta una tariffa di setup una tantum da $29. Le schede host qui sopra mostrano a quale macchina appartiene ogni prezzo.

Hailo-8 o Coral Edge TPU: quale scegliere?

Hailo valuta l'Hailo-8 fino a 26 TOPS e Google valuta il Coral a 4 TOPS, entrambi su int8. L'Hailo-8 ha anche software mantenuto: HailoRT 4.24.0 per esso è uscito a giugno 2026, mentre Google ha archiviato i repository del Coral. Scegli il Coral quando i tuoi modelli girano già su un Edge TPU.

Un server TPU può eseguire un LLM?

No. Nessuno dei due moduli può contenere un modello con miliardi di parametri, a qualsiasi quantizzazione. Dimensiona il modello sulla nostra pagina di hosting LLM, poi eseguilo su un server dedicato con GPU o su una delle nostre macchine Ryzen AI.

Quali sistemi operativi e driver funzionano?

Qualsiasi sistema offerto dal configuratore per la cartuccia può essere installato. HailoRT è compilato per Linux e Windows; il runtime Coral e i suoi fork della community puntano a Linux. Installiamo il sistema e tu installi il runtime nella versione che scegli.

Dove si trovano i vostri server TPU?

I server TPU sono venduti in queste città: New York, Bucharest, San Francisco, Amsterdam, Miami. Girano sulla nostra rete, AS19624. Gli ordini in queste città sono fatturati in euro, con le stesse cifre: Bucharest, Amsterdam.

La TPU è condivisa con altri clienti?

No. Il modulo si trova dentro la tua cartuccia e la macchina ha un solo tenant. Ottieni root e la console remota, e nessun carico di lavoro di altri clienti vi gira sopra.

Scegli una cartuccia, seleziona il modulo

Domande prima di ordinare? La nostra chat AI risponde in pochi secondi e può controllare account e server, e una persona subentra ogni volta che lo chiedi.

Configura un m710x