GPU e IA · Inferência na borda

Servidor TPU em bare metal.Um Coral Edge TPU ou um Hailo-8, em uma máquina Xeon que é só sua.

Um servidor TPU na Server Room é um cartucho HPE Moonshot com um Google Coral Edge TPU ou um módulo Hailo-8 no slot M.2, alugado por mês com acesso root. Ele roda modelos de visão int8 ao lado dos seus dados. Não é um Google Cloud TPU, que só o Google aluga, e não treina nem serve modelos de linguagem grandes.

  • Um locatário por máquina
  • Opção M.2 no m710x e no m510
  • Root e console remoto
  • Rede própria, AS19624

Escolha o cartucho host, marque o módulo no configurador e instale o runtime do fabricante no sistema que você selecionou. A Hailo classifica o Hailo-8 em até 26 TOPS e mantém a toolchain atualizada. O Google classifica o Coral em 4 TOPS, e ele se adapta a pipelines já construídos para o Edge TPU.

Definição

O que é um servidor TPU, e o que não é

TPU significa unidade de processamento tensorial, o nome que o Google deu aos seus próprios aceleradores de matriz. Duas peças muito diferentes carregam esse nome. Cloud TPUs são chips grandes para treinar e servir modelos, e o Google os aluga apenas dentro do Google Cloud. O Edge TPU é o pequeno: cerca de dois watts, somente inteiros, feito para rodar um modelo de visão compilado ao lado de uma câmera ou de um feed de sensor.

Alugamos o tipo pequeno e seu rival mais próximo, o Hailo-8, como módulo M.2 dentro de um servidor dedicado. Ambos são aceleradores de IA de borda: rodam uma rede neural que já foi treinada e quantizada para int8, e não fazem mais nada.

Dimensionado para

Detecção de objetos em quadros de vídeo, classificação de imagens, segmentação e estimativa de pose. Redes das famílias MobileNet, EfficientDet-Lite e YOLO, quantizadas para int8 e compiladas para o módulo, pontuam um quadro sem que os dados saiam da sua máquina.

Não dimensionado para

Treinamento de qualquer tipo. Modelos de linguagem, em qualquer quantização: nenhum dos módulos consegue armazenar bilhões de parâmetros. Modelos Float32 que não quantizam, e camadas que o compilador do fabricante não suporta, que caem para o processador ou falham ao compilar.

Para onde esses vão em vez disso

Dimensionar um modelo de linguagem é tarefa da hospedagem de LLM. Treinamento e inferência grande rodam em servidores dedicados com GPU, com uma GPU dedicada por máquina. Uma NPU e um grande pool de memória em uma caixa são os servidores Ryzen AI.

Os dois módulos M.2

Hailo-8 ou Coral Edge TPU

Ambos os módulos recebem uma rede int8 compilada antecipadamente pelo compilador do próprio fabricante. Eles diferem na vazão nominal, nos frameworks que aceitam e, desde que o Google arquivou o software do Coral, em quem ainda mantém a stack.

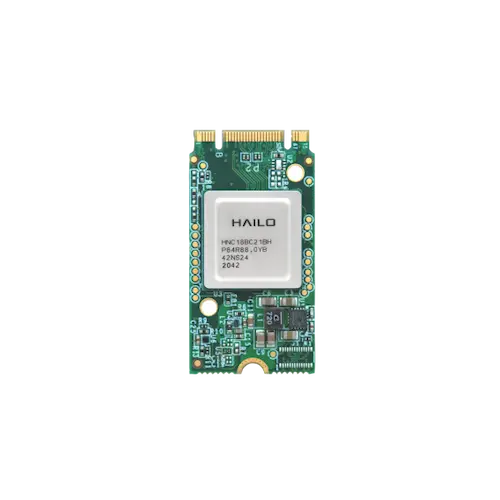
Módulo de aceleração de IA Hailo-8 M.2, vista superior
Toolchain mantida

Módulo Hailo-8 M.2

Classificação (da Hailo)
até 26 TOPS, int8
Fator de forma
M.2 Key M, 22 × 42 mm, estende-se para 2280
Interface
PCIe Gen 3
Origens de modelo
TensorFlow, TensorFlow Lite, ONNX, Keras, PyTorch
Toolchain
Dataflow Compiler, HailoRT, Model Zoo
Runtime para Hailo-8
HailoRT 4.x, branch hailo8 (4.24.0, junho de 2026)
Preço da opção
a partir de $13.99/mês

O Dataflow Compiler quantiza sua rede e a compila para um arquivo HEF, e o HailoRT roda esse arquivo a partir de C++ ou Python. Use a branch hailo8: o HailoRT 5.x e a branch master suportam apenas o Hailo-10 e o Hailo-15.
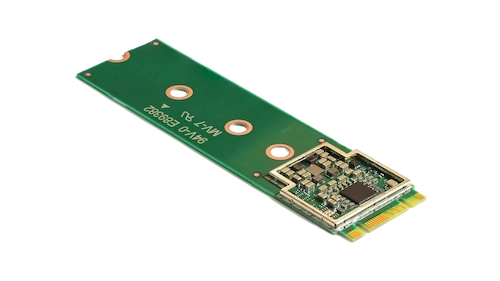
Acelerador Google Coral M.2 com Edge TPU
Arquivado pelo Google

Acelerador Google Coral M.2

Classificação (do Google)
4 TOPS, int8, a 2 TOPS por watt
Processador
Google Edge TPU
Origens de modelo
TensorFlow Lite, int8, através do Edge TPU Compiler
Runtime
libedgetpu e PyCoral, último lançamento do PyCoral 2.0.0 (julho de 2021)
Manutenção
Repositórios do Google arquivados; forks da comunidade o compilam hoje
Preço da opção
a partir de $13.99/mês

Um modelo ou compila para o Edge TPU ou não compila, e os modelos de visão estabelecidos compilam. O Google arquivou o libedgetpu, o PyCoral e os repositórios do Edge TPU, então kernels atuais e versões de Python dependem de forks da comunidade do runtime e do driver PCIe. Escolha-o quando seus modelos já rodam em um Edge TPU. Para um projeto novo, comece no Hailo-8.

Os números de vazão são a classificação de cada fabricante. Não publicamos benchmark próprio: quadros por segundo dependem do seu modelo, do tamanho da entrada e do lote.

Caminho dos dados

Como o offload funciona dentro de uma máquina

O Xeon continua a descodificar o vídeo, a redimensionar cada frame e a executar a sua aplicação. O módulo fica apenas com a rede neural, para que os núcleos permaneçam livres para o trabalho à volta dela. No m710x, os gráficos Iris Pro P580 do processador podem descodificar vídeo por hardware com o Quick Sync, o que deixa os seus quatro núcleos para o resto.

Direto do catálogo de encomendas

Dois cartuchos host, com o preço tal como o checkout os apresenta

O módulo é uma linha de opção em dois cartuchos HPE Moonshot: o m710x com um Xeon E3 de quatro núcleos, e o m510 com um Xeon D de 8 ou 16 núcleos. Cada preço abaixo é a configuração de entrada dessa linha, com o módulo como uma linha adicional por cima.

HPE ProLiant m710x

Intel Xeon E3-1585L v5

Intel Xeon E3-1585L v5 Quad Core 3.00 Ghz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Máquina, configuração de entrada
$62.58/mês
+ Google Coral Edge TPU
$13.99/mês
+ Hailo-8
$13.99/mês
Instalação, uma vez
$29
Cidades
New York, Bucharest, San Francisco, Amsterdam, Miami

Faturado em euros em Bucharest, Amsterdam, com os mesmos valores.

Configurar o m710x

HPE ProLiant m510

Intel Xeon D-1548 / Intel Xeon D-1587

Intel Xeon D-1548 Octa Core 2.00 GHz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Máquina, configuração de entrada
$62.58/mês
+ Google Coral Edge TPU
$13.99/mês
+ Hailo-8
$13.99/mês
Instalação, uma vez
$29
Cidades
New York, Miami, Bucharest, Amsterdam, San Francisco

Faturado em euros em Bucharest, Amsterdam, com os mesmos valores.

Configurar o m510

Um módulo altera a máquina, por isso a encomenda é uma configuração personalizada e inclui a taxa de instalação única indicada. Memória, discos, velocidade da porta e o período de faturação são definidos no mesmo configurador, que mostra o total mensal final antes de pagar.

Configuração

Da encomenda à primeira inferência

Instalamos o sistema operativo e entregamos-lhe o root. O runtime do fabricante não vem pré-instalado, para que a versão seja sua para escolher e fixar.

  1. Configure o host. Abra o configurador do m710x ou do m510, selecione o Hailo-8 ou o Coral e escolha o sistema operativo.
  2. Verifique se o módulo está no bus. Execute lspci -nn | grep -Ei '1e60|1ac1'. O Hailo-8 aparece como 1e60:2864 e o Coral como 1ac1:089a.
  3. Hailo-8: instale o driver PCIe e o HailoRT da linha 4.x (o ramo hailo8 de hailo-ai/hailort, ou os pacotes da Developer Zone da Hailo) e depois execute hailortcli fw-control identify para ler o firmware e o número de série do módulo.
  4. Coral: compile o driver PCIe gasket e apex e o libedgetpu a partir de um fork mantido, carregue o driver e verifique se /dev/apex_0 existe antes de executar o seu primeiro modelo.
  5. Fixe as versões. Mantenha o kernel, o driver e o runtime em versões que funcionem em conjunto. Nada do nosso lado atualiza a máquina sem o seu conhecimento.

Respostas

Perguntas sobre servidores TPU

O que é um servidor TPU?

Um servidor com uma unidade de processamento tensorial ligada a ele. Na Server Room, é um cartucho dedicado HPE Moonshot com um Google Coral Edge TPU ou um Hailo-8 na ranhura M.2, para inferência int8 em modelos de visão. As Cloud TPUs da Google são um chip diferente e muito maior, alugado apenas dentro da Google Cloud.

Posso alugar uma Google Cloud TPU convosco?

Não. As Cloud TPUs estão disponíveis apenas na Google Cloud, e nenhuma empresa de alojamento pode instalar uma. Para treinar ou servir modelos grandes em hardware que controla, veja os nossos servidores dedicados com GPU, onde cada máquina tem uma GPU dedicada.

Quanto custa um servidor TPU?

Uma máquina completa com um Hailo-8 ou um Coral começa em $76.57 por mês. O módulo é uma linha adicional por cima da máquina, a partir de $13.99 por mês para o Hailo-8 e a partir de $13.99 para o Coral, e a encomenda inclui uma taxa de instalação única a partir de $29. Os cartões de host acima mostram a que máquina pertence cada preço.

Hailo-8 ou Coral Edge TPU: qual devo escolher?

A Hailo classifica o Hailo-8 em até 26 TOPS e a Google classifica o Coral em 4 TOPS, ambos em int8. O Hailo-8 também tem software mantido: o HailoRT 4.24.0 para ele saiu em junho de 2026, enquanto a Google arquivou os repositórios do Coral. Escolha o Coral quando os seus modelos já correm num Edge TPU.

Um servidor TPU pode executar um LLM?

Não. Nenhum dos módulos consegue conter um modelo com milhares de milhões de parâmetros, em qualquer quantização. Dimensione o modelo na nossa página de alojamento de LLM e depois execute-o num servidor dedicado com GPU ou numa das nossas máquinas Ryzen AI.

Que sistemas operativos e drivers funcionam?

Qualquer sistema que o configurador ofereça para o cartucho pode ser instalado. O HailoRT é compilado para Linux e Windows; o runtime do Coral e os seus forks da comunidade destinam-se a Linux. Nós instalamos o sistema e você instala o runtime na versão que escolher.

Onde estão localizados os vossos servidores TPU?

Os servidores TPU são vendidos nestas cidades: New York, Bucharest, San Francisco, Amsterdam, Miami. Funcionam na nossa própria rede, AS19624. As encomendas nestas cidades são faturadas em euros, com os mesmos valores: Bucharest, Amsterdam.

A TPU é partilhada com outros clientes?

Não. O módulo fica dentro do seu cartucho e a máquina tem um único inquilino. Recebe root e a consola remota, e nenhuma carga de trabalho de outro cliente corre nela.

Escolha um cartucho, selecione o módulo

Dúvidas antes de encomendar? O nosso chat com IA responde em segundos e pode verificar a sua conta e os servidores, e uma pessoa assume sempre que pedir.

Configurar um m710x